2026-09-18
Glama 部署这条路上,真实踩过的六个坑
记录一次针对第三方托管平台的真实多轮排查过程,不是一次干净利落的修复——每一轮都是一个不同的真实报错,这里原样引用,没有事后美化。
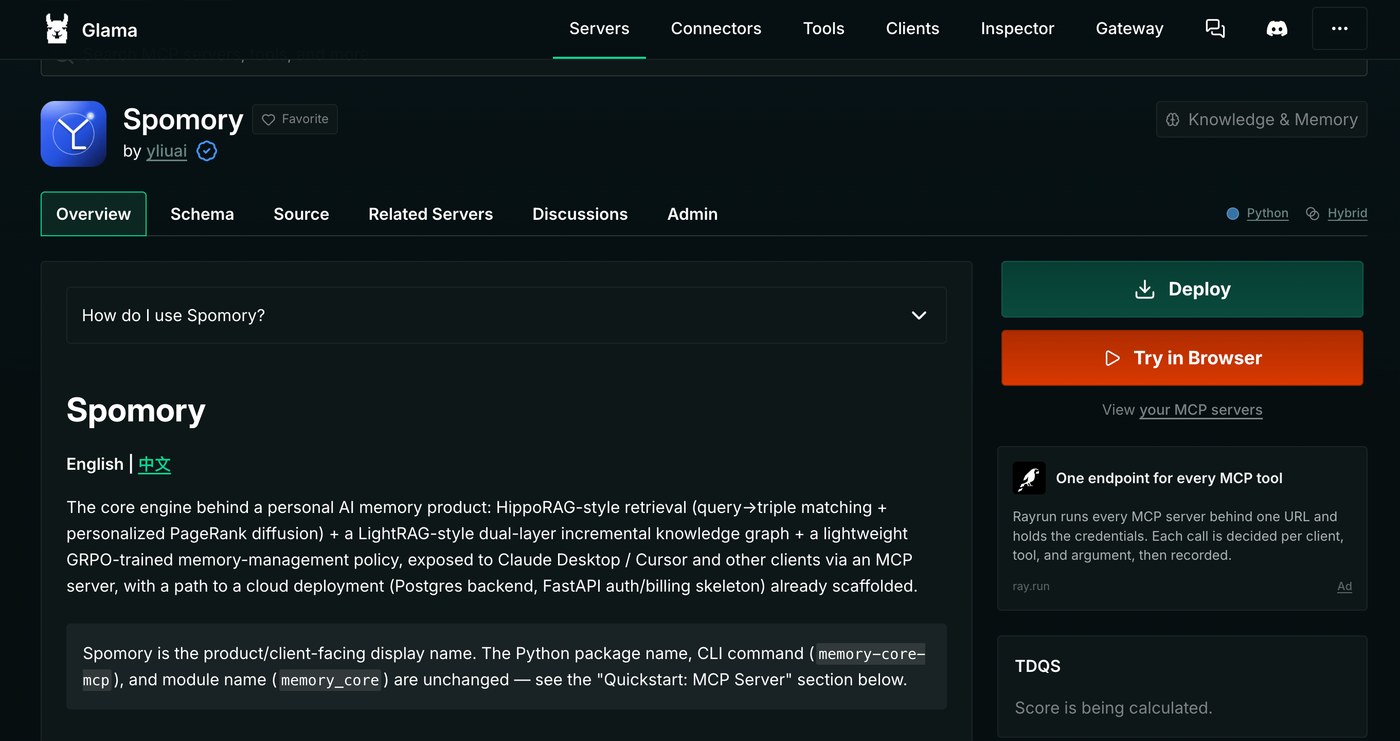
起点:没有任何解释,只有「cannot be deployed」
Glama 是一个 MCP 目录网站,同时提供已收录 server 的一键托管部署功能。Spomory 的页面上显示灰色不可点的「Deploy Server」按钮,下面一行小字:「This server cannot be deployed.」——没有报错,没有日志,没有任何线索说明缺了什么。
第一个猜测:加个 Dockerfile
最直觉的第一反应是缺 Dockerfile——Glama 总得靠某种方式把服务打包成容器。Spomory 仓库当时确实没有,于是加了一个并在本地验证过:真实的 `docker build` 构建成功,真实的 `docker run` 传一个占位用的 `LLM_API_KEY` 也能正常常驻不崩溃。这个 Dockerfile 本身是对的。
但在 Glama 那边完全没有变化,按钮还是灰的。这是第一个信号,说明这不会是一次一行代码就能解决的修复——后来才搞清楚,Glama 根本不用仓库自己的 Dockerfile,它会根据检测到的语言自己合成一套构建方案,并且只有认领了这个 listing 之后,才能直接编辑那套方案。
通过 glama.json 认领这个 listing
认领需要两步:往仓库里加一个 `glama.json`,写明 GitHub 维护者账号;然后用这个 GitHub 账号登录 Glama 自己的网站确认所有权。文件很简单:
{
  "$schema": "https://glama.ai/mcp/schemas/server.json",
  "maintainers": ["lyf-wxy"]
}
真实报错 #1:一个 Glama 找不到的命令
认领之后解锁了一个可编辑的「Docker Builds」配置面板——这才是 Glama 真正在用的方案,不是仓库自己那个 Dockerfile:
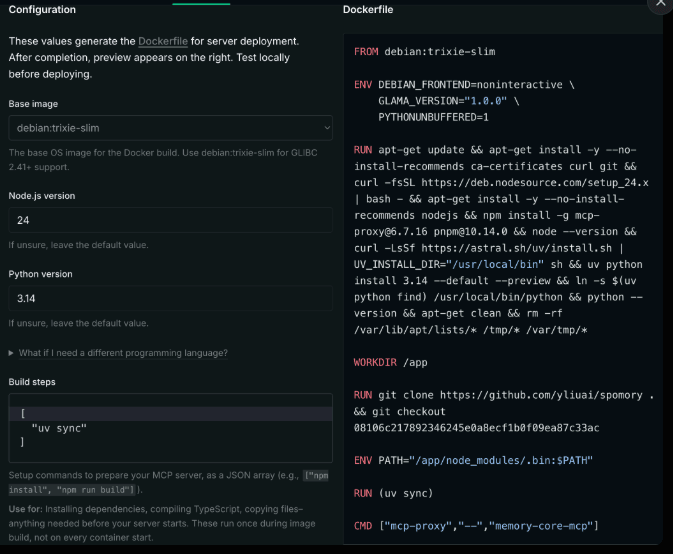
第一次针对这套配置的真实测试直接崩了,以下是 Instance logs 里的原文:
could not start the proxy Error: spawn memory-core-mcp ENOENT
    at ChildProcess._handle.onexit (node:internal/child_process:287:19)
    at onErrorNT (node:internal/child_process:525:16)
    at process.processTicksAndRejections (node:internal/process/task_queues:90:21) {
  errno: -2,
  code: 'ENOENT',
  syscall: 'spawn memory-core-mcp',
  path: 'memory-core-mcp',
  spawnargs: []
}
命令名本身没错——`memory-core-mcp` 确实是 `pyproject.toml` 里定义的真实命令。真正的问题在「CMD arguments」这个字段,也就是 Glama 用来启动服务的那句原始命令:
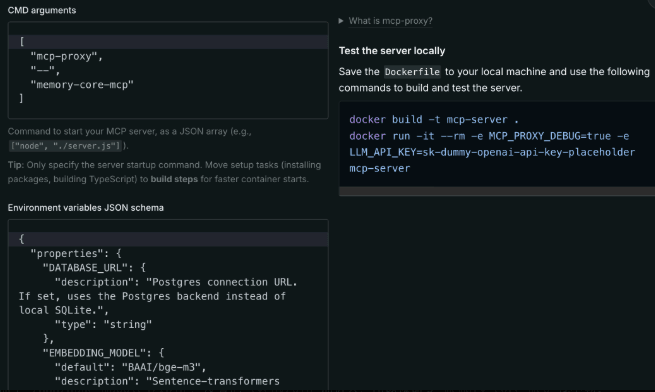
["mcp-proxy", "--", "uv", "run", "memory-core-mcp"]真实报错 #2,提前排查出来的:可选依赖没装
重新测试之前,先查了一遍 `pyproject.toml`,发现 `llm`、`embedding`、`mcp` 全都是可选依赖组——裸的 `uv sync` 一个都不会装,下一轮跑起来大概率会从「找不到命令」变成「缺依赖导致的 import 报错」。Build steps 需要显式声明这几个 extras:
["uv sync --extra llm --extra embedding --extra mcp"]真实报错 #3:进程真的启动了,但 Glama 还是把它杀了
两处都修完之后,这一轮跑得远多了——Python 进程真的启动了,Instance logs 里能看到一个真实的 embedding 模型完整加载完成:
Loading weights: 100%|██████████| 391/391 [00:00<00:00, 16767.95it/s]
/root/.local/share/uv/python/.../resource_tracker.py:475: UserWarning: resource_tracker: ...
could not start the proxy SdkError: Connection closed
没有任何 traceback——进程就是在模型加载完的瞬间不再响应了。真正的报错在外面一层:「Container exited with code 1 before responding to ping.」——这句话才是真正的线索:Glama 会 ping 一个刚启动的容器确认它还活着,而 Spomory 的 MCP Server 在启动时会同步加载一个几百 MB 的多语言 embedding 模型——这几秒钟里整个进程被彻底阻塞,答不上任何请求,包括这个 ping。Glama 的健康检查超时,直接把它杀了。
class SentenceTransformerProvider(EmbeddingProvider):
    """Loads its model lazily, on the first `embed()` call, rather than in
    `__init__`: constructing this class runs at MCP server startup, and
    eagerly loading a multi-GB multilingual model there blocks the process
    for several seconds before it can respond to anything -- including a
    health-check ping, which some hosts (e.g. Glama's container deploy)
    time out and kill before the server ever comes up."""

    def __init__(self, model_name: str | None = None) -> None:
        self.model_name = model_name or os.environ.get("EMBEDDING_MODEL", DEFAULT_MODEL_NAME)
        self._model = None

    def _get_model(self):
        if self._model is None:
            from sentence_transformers import SentenceTransformer
            self._model = SentenceTransformer(self.model_name)
        return self._model
模型加载从 `__init__` 挪到了一个私有的 `_get_model()`,只在 `embed()` 里才会被调用——也就是第一次真正的检索或写入,而不是服务器一启动。下一轮测试:状态 `success`,耗时 1 分 19.2 秒,Instance logs 里能看到真实的 JSON-RPC 流量——`tools/list` 正确返回全部六个工具,包括 `export_memory` 的完整 schema,`prompts/list`、`resources/list` 也都干净地answer了。服务这次是真的跑起来了。
真实报错 #4:测试通过了,但还是变不成一次部署
在 Glama 上,构建测试通过不等于能部署——还有一个单独的「Make Release」动作,跟一个真实的 GitHub Release 绑定,对应 Admin 面板里本来就有的一行提示:「Auto-Release: builds and publishes a new version on every GitHub release.」`yliuai/spomory` 仓库当时从来没发布过 Release。补了一个真实的 GitHub Release `v0.1.1`,对应当时 PyPI 上已经发布的版本号,解决了这一步。
紧接着又出了一个真实的小失误:PyPI 上的包很快又重新发布成了 0.1.2,第一反应是 `v0.1.1` 这个 tag 是不是已经过时了。查了一下实际的 commit SHA,发现这个 tag 和 `main` 的 HEAD 完全是同一个 commit——那个 commit 里 `pyproject.toml` 写的本来就已经是 `0.1.2`。代码从来没有落后,只是这个 release 的名字标错了。修法是删掉 `v0.1.1`,在同一个 commit 上重新建一个 `v0.1.2`——是改名字,不是重新构建。
真正让这件事变复杂的地方
上面五个修复单独拿出来看,没有一个是真正复杂的。真正让这变成一次六轮排查的原因是:每修好一个问题,只会暴露出下一个——缺 Dockerfile 挡住了没认领这件事,没认领挡住了启动命令写错,启动命令挡住了缺依赖,缺依赖挡住了模型同步加载,模型同步加载挡住了发布这一步自己的 bug。上面引用的每一段日志,都是 Glama 在各自那个阶段真实打印出来的原文,不是事后整理美化过的复述。